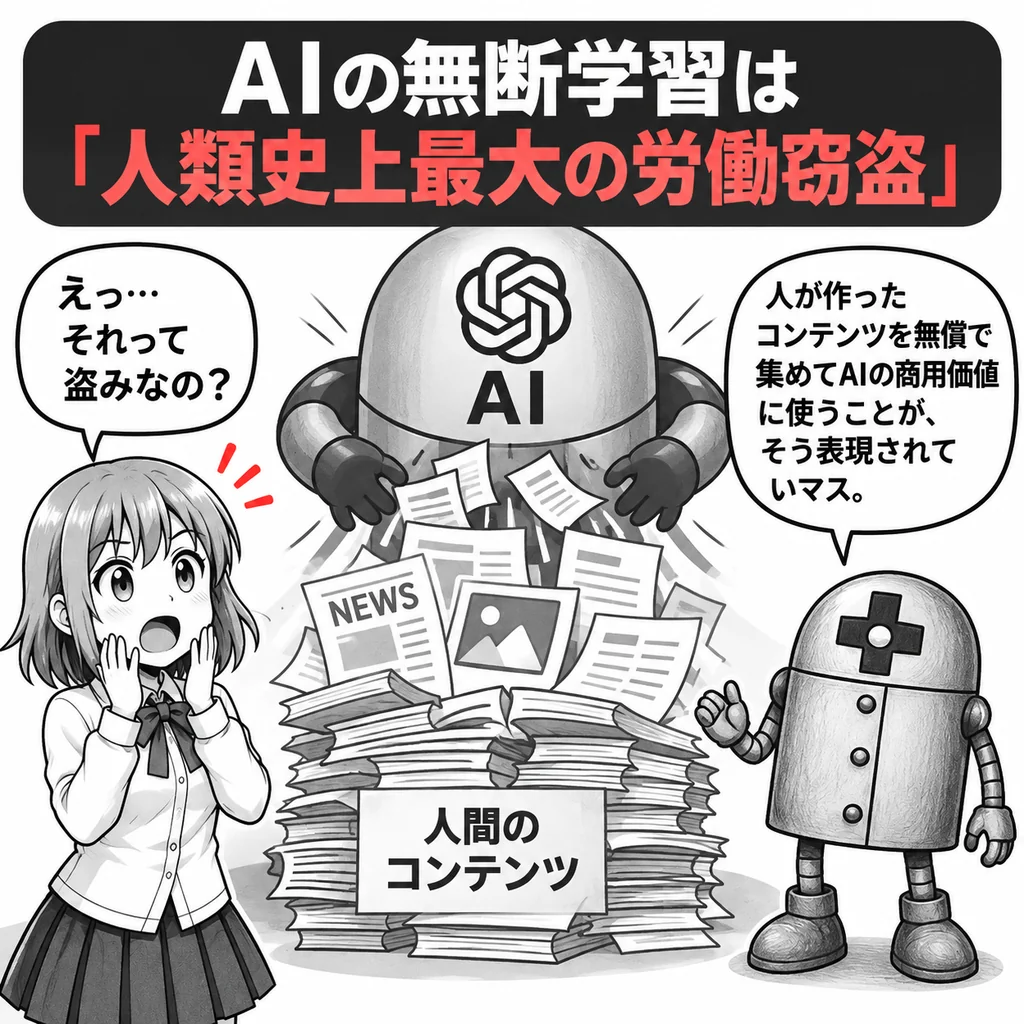
Microsoft研究幹部がAI学習を「人類史上最大の労働窃盗」と内部で警告 何を意味する?
何が起きた?
AIの学習にニュース記事などを大量利用したことをめぐる著作権訴訟で、Microsoft内部のかなり強い発言が明らかになった。
2026年9月17日に公開された裁判資料によると、Microsoftで応用科学部門のディレクターを務めるBrent Hecht氏は、2023年の社内文書でAIのための大規模なコンテンツ収集について、「人類史上最大の労働の窃盗」になり得るという趣旨の表現を使っていた。
さらに別の内部資料では、「前例のない規模の驚くべき窃盗」とも表現していたとされる。
これは、The New York Timesなどの報道機関がOpenAIとMicrosoftを相手取って起こしている著作権訴訟の証拠開示によって表に出たものだ。
ただし重要なのは、Microsoftという会社が「AI学習は窃盗である」と公式に認めたわけではないという点である。
Microsoftは、この発言は一社員の見解であり、法的分析でも会社としての見解でもないと説明している。
簡単にいうと
問題になっているのは、「AIが人間の仕事を奪う」という話だけではない。
もっと根本的な、
人間が作った文章や画像をAIの材料として大量に使い、そのAIが今度は元のコンテンツの代わりになるのではないか
という問題である。
たとえば料理店が、近所の農家から食材を無料でもらい続け、その料理を売って大きくなったとする。
ところが農家にはお金が入らないため、やがて農家そのものがなくなってしまう。
AIとニュースメディアについてMicrosoft内部で懸念されていたのも、これに近い構造だ。
記事を書く人や出版社のコンテンツをAIが利用し、そのAIが記事を読まなくても答えを教えてくれるようになれば、元のサイトへ人が来なくなる。
すると広告収入や購読料が減り、最終的には新しい記事を作れる人や会社そのものが減ってしまう可能性がある。
「誰の労働を盗む」という意味なの?
ここでいう「労働」は、単に新聞記者の労働だけを意味しているわけではない。
記者、作家、写真家、イラストレーター、研究者、ウェブサイト運営者など、インターネット上にコンテンツを作ってきた人たちの創作労働を広く指している。
もちろん「労働窃盗」は法律上の正式な用語ではない。
会社が従業員の給料を支払わない「賃金窃盗」の意味でもない。
人間が時間と労力をかけて作った成果物を大量に集め、それを使って商用AIを作りながら、元の制作者には十分な対価が支払われない――その構造を強く批判するための表現である。
Hecht氏自身は現在MicrosoftのPartner Director of Applied Scienceで、AIと仕事、生産性、そしてAIとコンテンツ制作者が共存できる仕組みなどを研究している。
つまり、単純な「AI反対派」の発言というより、AI産業を成立させるためにもコンテンツを作る側を維持する必要があるという問題意識から出た言葉と見る方が実態に近い。
Microsoft内部では「破滅の循環」まで心配していた
さらに興味深いのが、Microsoft内部で使われていた「doom loop」という表現である。
日本語にすれば「破滅の循環」といった意味になる。
裁判資料で引用されたMicrosoftの内部資料では、AIがウェブサイトへのアクセスを奪うことで、
AIが記事を利用する
→ AIだけで答えが分かる
→ 元の記事を読みに行く人が減る
→ メディアの収入が減る
→ 記事を作れる人が減る
→ AIが利用できる良質な新しい情報も減る
という悪循環が起きる可能性が指摘されていた。
Microsoft自身のデータとして、Copilotのような「答えを直接表示する検索」を使った場合、従来のBing検索と比べて、一部の報道サイトへのクリック率が大幅に低下したという数字も裁判資料に出ている。
つまりMicrosoft内部ではかなり早い段階から、
AIが既存のウェブを便利に利用するだけでなく、AI自身が必要としている「情報を作る産業」を弱らせる可能性
まで認識されていたことになる。
ではAIの学習は違法なの?
ここはまだ決着していない。
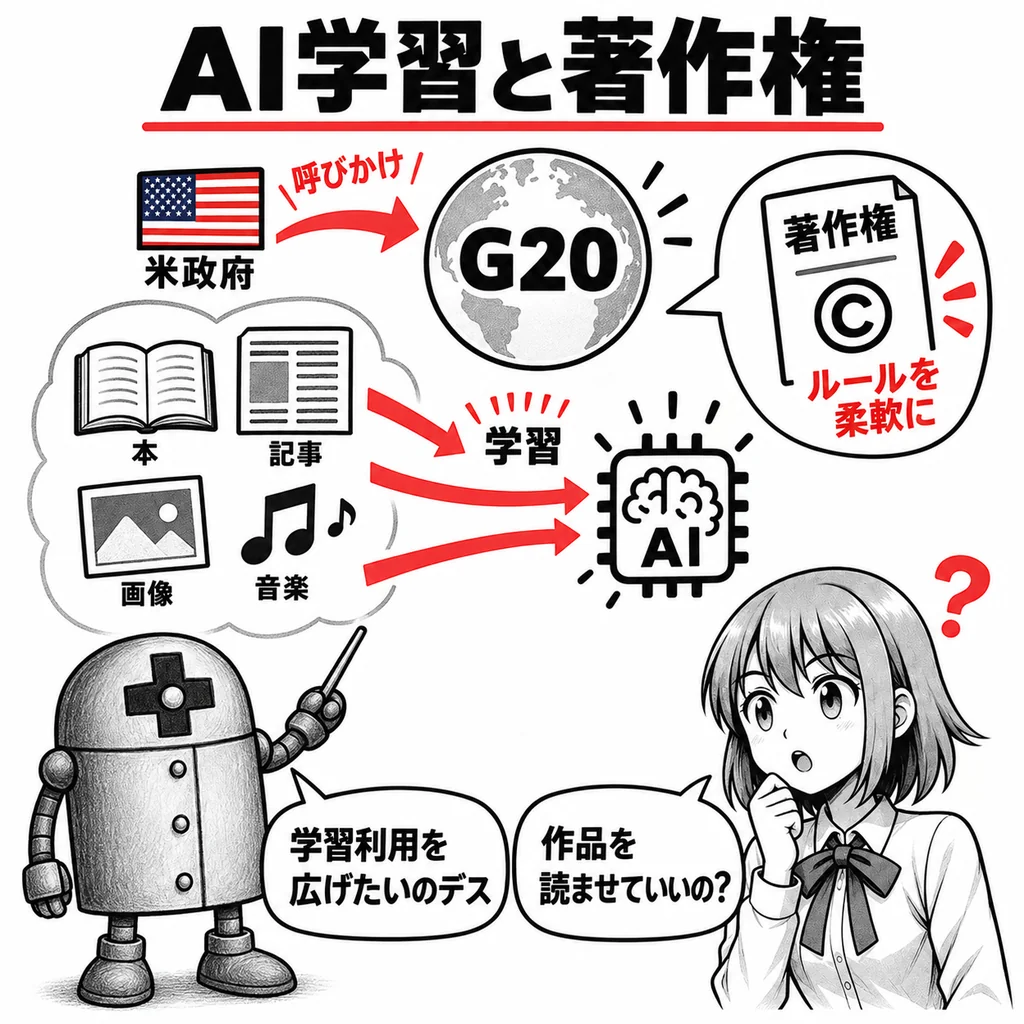
OpenAIとMicrosoftは、著作物をAIの学習に利用することについて、米国著作権法上の「フェアユース」に当たると主張している。
フェアユースとは、一定の条件を満たせば、著作権者の許可がなくても著作物を利用できる米国の制度である。
OpenAI側は、AIは記事をそのまま販売するためにコピーするのではなく、大量のデータから言語のパターンなどを学び、別の用途に利用しているため「変容的な利用」だと主張している。
一方、報道各社側は反論する。
AIがニュース記事を使って学習し、そのAIが記事を読まなくてもニュースを答えられるようになるなら、元の記事と市場で競合しているのではないかという考え方だ。
今回公開された内部発言が注目されているのもこのためである。
OpenAIのChatGPT責任者も内部では、AIが出版社にとって「存亡の脅威」になり得ることや、AIサービスが既存コンテンツを「代替する」性質を持つことを認識していたと原告側は主張している。
ただし、こうした内部発言があるからといって、それだけで著作権侵害が成立するわけではない。
現在公開されているものには原告側が提出した主張や証拠の引用も多く含まれており、裁判所が最終的に違法だと判断したものではない。
この問題はニュースサイトだけの話ではない
この裁判の対象は主に報道機関だが、問題の構造はもっと広い。
生成AIは、文章、画像、音楽、プログラムなど、人間が長い時間をかけて作ってきた大量のデータによって発展してきた。
その結果としてAIが便利になればなるほど、人間が作ったコンテンツを直接見る必要がなくなる場合もある。
すると、
「AIを作るために必要だった人間の仕事が、AIによって経済的に成り立たなくなる」
という矛盾が生まれる。
今回の内部文書が興味深いのは、AIに批判的な外部の人だけではなく、AIを大々的に推進しているMicrosoft自身の研究者も、この構造をかなり早くから問題視していたことが確認された点にある。
AI学習が法的にどこまで許されるのかだけでなく、
AIによって利益を得る企業と、AIの材料を作ってきた人々との間で、その利益をどう分けるのか。
今後はこちらの問題もますます大きくなりそうだ。
情報源
- Reuters「OpenAI, Microsoft executives’ quotes on AI training threaten copyright defense, news outlets argue」
- Microsoft Research「Brent Hecht」
- OpenAI「Reporting the facts about the New York Times’ lawsuit」
- TechCrunch「Microsoft exec called AI scraping ‘the largest theft of labor in human history,’ new unredacted filings reveal」